

はじめに
みなさん、こんにちは。もう5月も残り10日を切りました。
本社のある札幌では、ライラックが見頃を迎えています。新緑の季節ですね!
さて、入社して1ヶ月半ほど経ち、ゴミ出しの記事を制作してきましたが、その一方でさまざまなAIも触れてきました。その中で、それらはLLMやSLMと呼ばれていますが、何気なく使っているこの言葉を一度整理しようと思い、今回記事にしてみました。
さらに、今回は、いままでゴミ出しのデータベースでやってきたことを、これらの技術で補えるのではないかと思い、記事にまとめてみました。ぜひご覧ください!
そもそも、LMとは
LM – Language Model (言語モデル)
そもそもLMとは、Language Model(言語モデル)のことで、皆さんが日常で使用する言葉を機械が理解するアルゴリズムのことを言います。機械が人間の話すような自然の言葉を理解するのが、LMというわけですね。
LLM – Large Language Model (大規模言語モデル)
それの頭にLがついたのが、最近よく言われるLLMというものです。Lとは、Largeの意味で、その名の通り、たくさんの言語のデータを扱います。皆さんが使ったことであろうchatGPTはこれに当てはまります。膨大なデータを学習しているので、みなさんご存知の通り、精度が非常に高いです。
SML – Small Language Model (小規模言語モデル)
頭にSがついた、SMLというものもあります。これは、あまり聞かない言葉ですが、S(Small)の通り、特定の分野に特化させて学習させたLM(言語モデル)です。例えば、今回のゴミ出しのように、ゴミ出しに特化させて、対話できるようにするなどは、これに当てはまると思います。
さらに詳しく
今回こちらの記事を参考にさせていただき、LMについて学びました。
メリットやデメリットなど、さらに詳しい内容もまとまっていますので、興味のある方はご覧ください。

NotebookLMとゴミ出しアプリへの活用法
NotebookLMって?
さて、〇LMが多い中で、サービスの名前にLMというのが入っているものもあります。NotebookLMは、さまざまなデータ(音声や画像、テキストやPDFなど)を蓄積し、そのデータからチャットで検索や分析、要約などをしてくれる、Googleが提供してくれている素敵なサービスです。

さらに詳しく知りたい方は、Geminiの公式noteで紹介されていましたので、ぜひご覧ください!
ゴミ出しアプリ
蓄積されたデータを使って回答してくれるという仕組みは、これまでデータベースで作ってきた内容と似ているところがあります。(というか、そのままですね!)データベースと違うのは、CSVや手作業でテーブルを入れたり作ったりするわけではなく、自然言語をデータとして入れていくという点です。
NotebookLMでは、テキストデータをはじめ、画像やJEG、URLや音声データなどをデータとして蓄積してくれます。これが、例えば地域のゴミ出しに関する情報を蓄積できれば、ゴミ出しLMとして機能できそう!と思ったわけです。そうすれば、わざわざテーブルを操作する必要もなく、気軽にゴミ出しに関しての情報を蓄積でき、チャットしたら返答してくれるアプリができそうです。
ゴミ出しLMを作ってみよう
必要な技術
では、ゴミ出しLM(仮ですが・・・)を作るにあたって、どのような技術が必要になってくるのでしょうか。chatGPTに質問してみたところ、次のように表にしてまとめてくれました。
| 項目 | OpenAI API 使用時 | ローカルLLM(Ollama)使用時 |
|---|---|---|
| LLMモデル | GPT-3.5 / GPT-4(OpenAI) | Mistral / LLaMA3 / Gemma(Ollama) |
| APIキー | 必須(OPENAI_API_KEY) | 不要 |
| Embedding生成 | openai.Embedding.create()(API経由) | sentence-transformers(ローカル) |
| ベクトル検索エンジン | FAISS(ローカル) | FAISS(ローカル) |
| テキストデータ取得 | PDF/Text/Web手動抽出 or langchainなど | 同様(PDF, HTML, etc.) |
実現する方法については、2通りまとめてくれました。これは、使用するLLMモデルによって、APIキーで課金が必要になってしまうためです。
Embeddingは、言葉を意味ベースの数値(ベクトル)に置換する技術です。これは、言葉を数値として考えるもので、似てる言葉(例えば、[梅おにぎり][わかめおにぎり]・・・)は似ている数値(例えば、[0.32, -0.65, 0.99, …][0.37, -0.63, 0.98…]・・・)に変換します。
ベクトル検索エンジンは、先ほどベクトル化したものから、近いベクトルを探し出してくれる検索エンジンです。これは、すでにベクトルかされた文章があった時、質問された文章に近い文章(一番関連が深い文章)を見つけてくるものです。
例えば、v1 = 梅おにぎりは好き、v2 = たらこおにぎりは普通、v3 = 山わさびおにぎりは苦手、とベクトル化された文章があった時に、「山わさびおにぎりは好き?」と入力されたら、v3を一番近い文として回答するものです。
作ってみよう
今回は、まずは無料で試作できるローカルLLM(Ollama)を使ってゴミ出しLMを作ってみたいと思います。
まずは、自然言語を扱えるように、LLMをローカルで動かせるようにします。今回は、Ollamaというツールを使いました。ターミナルを使って、Ollamaをインストールし、モデルをダウンロードします。今回は、mistralというモデルを使用しました。
# Ollama をインストール
brew install ollama

# モデルをダウンロード
ollama run mistral

続いて、EmbeddingとFAISSで検索、Ollamaで回答、を一緒にできるように、ライブラリのインストールとPythonのプログラミングをしていきます。
下記のコマンドを使って必要なライブラリをインストールし、Embedding(ベクトル化)→回答までをしてくれるPythonファイルを作りましょう。今回はjsonファイルにテキストデータを入れておき、これを読み込ませて正しく回答するか試してみます。
# ライブラリをインストール
pip install sentence-transformers faiss-cpu
from sentence_transformers import SentenceTransformer
import faiss
import numpy as np
import json
# 1. JSONファイルからテキストデータを読み込み
with open("text.json", "r", encoding="utf-8") as f:
data = json.load(f)
# 2. Embeddingモデルの読み込みと変換
model = SentenceTransformer("all-MiniLM-L6-v2")
embeddings = model.encode(data["docs"]) # → (3, 384)のベクトル
# 3. FAISSインデックスの作成と保存
dimension = embeddings.shape[1] # ベクトルの次元数(384)
index = faiss.IndexFlatL2(dimension)
index.add(embeddings)
# 4. 検索用のクエリを入力
query = "牛乳パックは何ごみ?"
query_vec = model.encode([query])
# 5. FAISSでベクトル検索(最も近い1件を取得)
distances, indices = index.search(query_vec, k=1) # k=1は上位1件
# 6. 結果を表示
print("🔍 クエリ:", query)
print("🧠 一番近い文:", data["docs"][indices[0][0]])
print("📏 距離スコア:", distances[0][0]){
"docs": [
"牛乳パックは資源ごみとして出してください。",
"プラスチックごみは洗って出しましょう。",
"燃えるごみは週2回回収されます。"
]
} 実行してみる
作ったファイルを実行する前に、もう一度仕組みを確認してみましょう。
まず、今回のゴミ出しLMのソースは、3種類のゴミの情報が入ったjsonファイルになります。
その後、Pythonファイルの#1でjsonファイルが読み込まれ、#2,3でベクトル化・保存がされてデータとして蓄積されます。
続いて、質問をする部分は、先ほど作ったPythonファイル#4に入力します。その質問は、#5で、#3で保存されたデータの中から、一番近いベクトルのものを選んできます。
回答は#6で、私たちの見える形で答えてくれるような内容です。
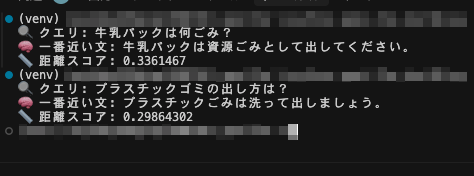
それでは、ターミナルを使って実行してみましょう。今回のPythonファイルを実行してみると、以下のような結果(画像上段)となりました。牛乳パックは資源ごみとして出してください。と一番近い文章を表示してくれています。無事動作しているようです!
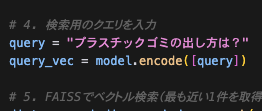
試しに別の質問もしてみました。jsonファイルでは、“プラスチックごみは洗って出しましょう。”という文章も読み込ませていますので、“プラスチックゴミの出し方は?”という質問を読み込ませてみます。
すると、これもしっかりとプラスチックごみは洗って出しましょう。という一番近い文章をしっかりと引き出すことができていました。
まとめ
今回はローカルLLMの技術を使って、テキストデータの情報から一番近い情報を回答してくれる、ゴミ出しLMを作ってみました。Githubにも内容を載せましたので、よければご覧ください。

テキストデータのまま返してしまっているので、これをchatGPTのようにするには、APIキーなどが必要になってくるようです。次回はその辺りも探りながら作っていきたいと思います!
ご覧いただき、ありがとうございました!